ASUS ProArt P16 (RTX Spark), análisis: Nvidia ha metido una pequeña fábrica de tokens en un portátil
Soplan nuevos aires en la industria de los PCs y los portátiles. Tras décadas de dominio imperial de la arquitectura x86, Nvidia quiere darle la vuelta a la tortilla con sus nuevos chips ARM, los RTX Spark. Viene avisando desde hace tiempo de sus intenciones, y esa ambición al fi
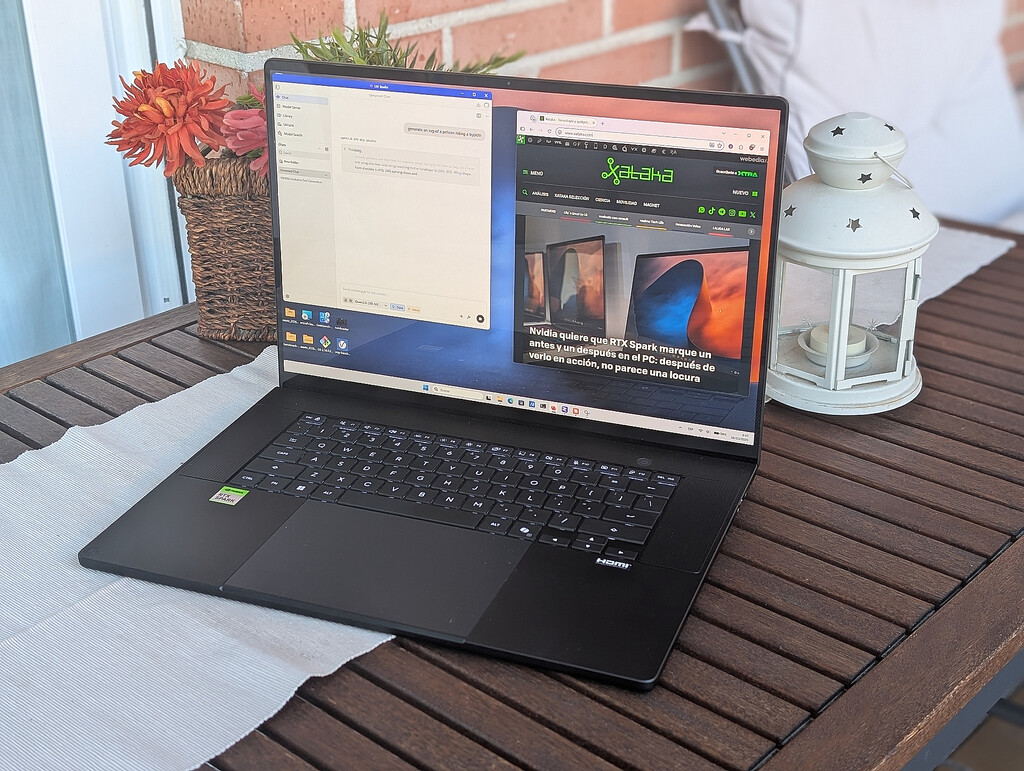
Soplan nuevos aires en la industria de los PCs y los portátiles. Tras décadas de dominio imperial de la arquitectura x86, Nvidia quiere darle la vuelta a la tortilla con sus nuevos chips ARM, los RTX Spark. Viene avisando desde hace tiempo de sus intenciones, y esa ambición al fin ha cristalizado.
Lo ha hecho con los primeros equipos basados en estos SoC, que desafían el statu quo del segmento y lo hacen además con una propuesta de lo más completa. Lo hemos podido comprobar de primera mano estos días, porque hemos tenido la oportunidad de sacar mucho jugo al ASUS ProArt P16, uno de los primeros equipos basados en esta plataforma de Nvidia.
Tenemos mucho de que hablar. Empecemos.
ARM como nunca habíamos visto a ARM en Windows
Nvidia llevaba años mirando de reojo el mercado de los PCs y portátiles con una ambición renovada. no le bastaba con suministrar las tarjetas gráficas que durante años han conquistado el mercado gaming: quería algo más. Quería ofrecer su propio SoC para iniciar una nueva era de portátiles Windows basados en sus chips con arquitectura ARM.
Nvidia quiere que RTX Spark marque un antes y un después en el PC: después de verlo en acción, no parece una locuraNo es el primero en intentarlo —hola, Qualcomm—, pero sí el que desde luego abarca esta tarea con un objetivo claro: mientras que anteriores intentos parecían tratar de convencernos de la validez de la arquitectura ARM por su eficiencia y su rendimiento por vatio, aquí Nvidia no se anda con chiquitas: estos chips son relativamente eficientes, sí, pero destacan sobre todo por su potencia.
Ficha técnica del ASUS ProArt P16 (H7607)
ASUS ProArt P16 (H7607, RTX Spark)
Pantalla
OLED 16" UHD+ (3.840 x 2.400) / 3K (2.880 x 1.800)
16:10, 120 Hz, 700/500 nits (estándar), 1.600/1.100 nits (pico)
Multitouch, HDR True Black 1400 / 1000, soporte stylus
Procesador
Nvidia RTX Spark N1X con CPU de 20 núcleos
Nvidia RTX Spark N1X con CPU de 18 núcleos
Gráficos
Nvidia Blackwell RTX con 6.144 núcleos
Nvidia Blackwell RTX con 5.120 núcleos
Memoria
24 / 32 / 48 / 64 / 128 GB memoria unificada LPDDR5X
Hasta 300 GB/s de ancho de banda
Almacenamiento
512 GB / 1 TB / 2 TB SSD NVMe PCIe 4.0
Ranura de expansión
2 x M.2 2280 PCIe 5.0x4
Puertos
3 x USB-C (USB 4.0 Gen 3, 40 Gbps)
1 x USB-A (USB 3.2 Gen 2, 10 Gbps)
1x 3,5 mm
1 x HDMI 2.1
Lector SD Express 7.0
Teclado y touchpad
Teclado retroiluminado (recorrido 1,7 mm)
Touchpad háptico
Webcam
Cámara Full HD
IR con soporte Windows Hello
Conectividad
Wi-Fi 7, Bluetooth 5.4
Batería
99,9 WHrs
Adaptador de 140 W, cable USB-C (240 W) incluidos
DImensiones y peso
354,1 x 243 x 12,9-15,9 mm
1,77 kg
Sistema operativo
Windows 11 Home / Pro
Precio
Desde 3.499 euros
ProArt P16 (H7607)
PVP en Asus — 3.499,99 € MediaMarkt — 3.999,00 € PcComponentes — 4.499,99 € El precio podría variar. Obtenemos comisión por estos enlacesUn diseño elegante y, sobre todo, contundente
El ASUS ProArt P16 (H7607BA) es uno de los primeros equipos que ofrecen estos chips, y lo hacen además acompañados de una configuración notable, sobre todo por esos hasta 128 GB de "memoria unificada" LPDDR5X que son la clave para poder cargar grandes modelos de IA locales.
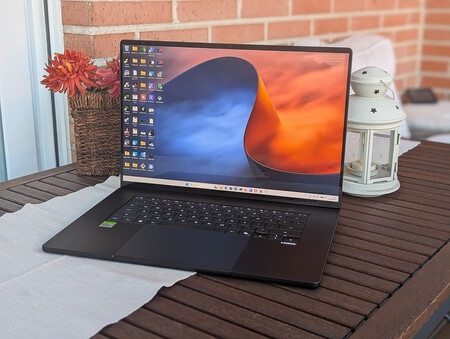
Nosotros, eso sí, hemos probado el equipo en color negro que cuenta con el RTX Spark en su versión con la CPU de 20 núcleos, GPU de 6.144 núcleos, 64 GB y pantalla OLED 3K.
Estamos ante un portátil con unos acabados cuidados, sobrios y elegantes. No hay aquí estridencias y lo que sorprende es una delgadez que tras las pruebas se nos ha antojado hasta exagerada.
Y es que esos 15,9 mm de grosor en la parte más "abultada" son todo un prodigio de la miniaturización, pero como veremos más adelante, quizás no hubiera estado de más dar algo más de margen a la refrigeración de un equipo que cuando se pone a trabajar de verdad no va sobrado de espacio para dejar escapar el calor generado por estos componentes.
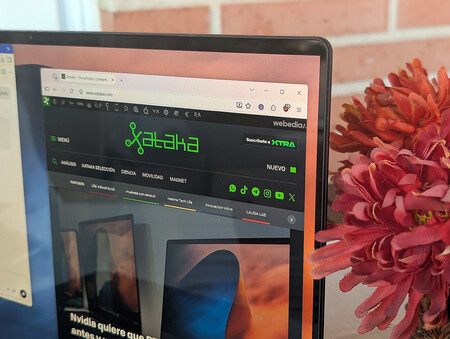
Sea como fuere, tener un equipo con pantalla de 16 pulgadas y estas dimensiones es todo un lujo: su peso de 1,77 kg lo convierte en un portátil denso y contundente. Uno que no engaña y que muestra desde el primer momento que está pensado para usuarios ambiciosos.
La pantalla OLED de 16 pulgadas tiene acabado brillo, y su calidad es sobresaliente: nosotros contamos con el panel 3K, y en dicha configuración los colores y el contraste son envidiables. La calidad de imagen y la resolución hacen que trabajar con el equipo en el apartado visual sea una gozada, pero también es posible exprimir esa pantalla con contenidos de vídeo con los que el panel destaca de forma clara.
Estamos además ante un panel con soporte multitouch en el que incluso podremos usar un stylus, pero cuidado. la pantalla no se abate del todo y no estamos ante un convertible. Aun así, ese soporte es más que bienvenido y ASUS completa el círculo con una tasa de refresco de 120 Hz y una webcam FHD con soporte Windows Hello.
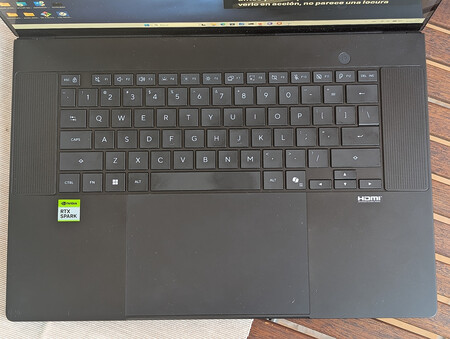
El teclado es fantástico: el tacto y recorrido de las teclas es excelente, y no tuvimos problemas en acostumbrarnos rápidamente a la distribución ANSI de EEUU, aunque aquí hay algún sacrificio ya tradicional como el de unas teclas de cursor que son la mitad del resto de las teclas normales para poder mantenerlas en esa fila inferior del teclado.
Mientras, el touchpad con tecnología háptica sigue esa tendencia que hemos visto y abrazado en los últimos tiempos en estos componentes: es enorme, y ocupa prácticamente la mitad de lo que ocupa el teclado. El tacto y el soporte de gestos es fantástico y la citada respuesta háptica se comporta a la perfección.
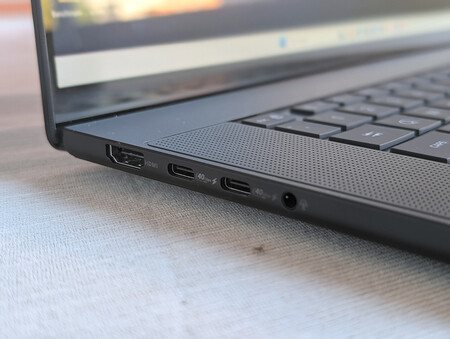
Los puertos disponibles cumplen: tenemos tres puertos USB-C (USB4) y hasta un puerto USB-A, y a ellos se une el puerto HDMI 2.1, el puerto de auriculares y hasta un lector de tarjetas SD. Quizás algunos echen de menos un puerto Ethernet, pero dado el grosor del equipo integrarlo era complicado.
La conectividad inalámbrica está también muy bien cubierta con el soporte Wi-Fi 7 y Bluetooth 5.4. En cuanto a la carga, con el equipo se incluye un (sorprendentemente) pequeño adaptador de 140 W y un cable USB-C que podremos usar en cualquiera de los puertos de este tipo que tenemos en el equipo.
El chip promete, la "memoria unificada" promete más
Sin embargo el protagonista absoluto del equipo es el SoC creado por Nvidia y MediaTek, el N1X que cuenta con una CPU de 18/20 núcleos y una GPU con arquitectura Blackwell (la misma de las RTX 50) de 5.120/6.144 núcleos.
En nuestras pruebas, la CPU del RTX Spark obtuvo 540 puntos en single core y 6.855 puntos en multicore en Cinebench 2026. Mientras, Geekbench 7 mostró 2.522 y 21.774 puntos respectivamente en esas configuraciones. Para hacernos una idea, estamos ante un SoC que claramente compite con el M4 Pro que por ejemplo obtiene 3.375 puntos en single core y 24.890 puntos en multi core en Geekbench 7.
Las cifras muestran que estamos ante un procesador más que decente pero que no brilla de forma espectacular en tareas monohilo. El chip sí gana enteros en multihilo, donde como vemos está cerca de ese M4 Pro, y aquí se nota que de momento en SoCs ARM Apple sigue marcando su poderío.
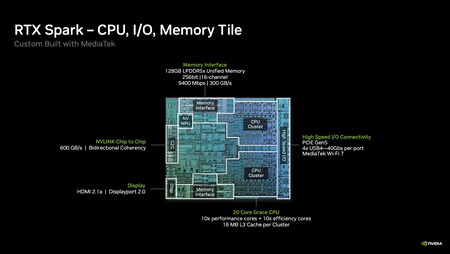
De hecho, el M4 Pro y el M4 Max se presentaron en octubre de 2024; el GB10 que es la base del N1X lo hizo en octubre de 2025. ¿La buena noticia? Este es solo el principio del camino para Nvidia, y sin duda las prestaciones de sus SoC ARM mejorarán en próximas generaciones.
La otra parte integral de esta apuesta es la "memoria unificada" (el mismo término que llevan años usando en Apple) que incluyen este equipo y sus "primos" del resto de fabricantes: hasta 128 GB de memoria que se comparte entre la CPU y la GPU.
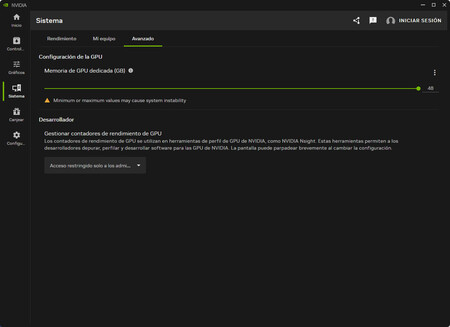 Con Nvidia App tenemos una forma sencilla de "redistribuir" la asignación de memoria a la GPU. En equipos de 64 GB podremos asignar hasta 48 GB al procesador gráfico.
Es posible cambiar la asignación de memoria fácilmente desde la aplicación Nvidia App: en el apartado Sistema->Avanzado veremos cómo podemos llegar hasta los 48 GB asignados a la GPU como máximo en este equipo, lo que deja 16 GB de memoria para el sistema operativo y las aplicaciones.
Jugar con esa configuración da algo más de margen para cargar modelos de IA con mayor ventana de contexto, y es una forma sencilla de aprovechar al máximo este recurso. Cada cambio, eso sí, necesitará un reinicio de la máquina para que se aplique.
Usando la IA local como si no hubiera mañana
Aunque el equipo se comporta muy bien en todos los ámbitos, hay un área en el que brilla de forma especial. Y ese área es, por supuesto, la ejecución de modelos locales de IA. Esos 64 GB de memoria unificada y la destacable GPU del SoC N1X dan aquí mucho juego, y desde el primer momento quisimos saber qué podíamos esperar de este equipo.
Para ello ejecutamos una batería de pruebas recomendadas por Nvidia y que nos permitieron demostrar que la velocidad de decodificación (generación de tokens) con el popular modelo Qwen3.8-27B era más que decente en esas pruebas.
Prueba
Qwen3.8-27B (UD-Q4_K_M) con DFlash 2
Speedbench, decodificación (tokens/S)
27,22
AgentPerf Local, decodificación (tokens/s)
35,96
AgentPerf Local, tiempo normalizado (s)
1.052,33
Contexto 16k: primer token (s)
22,57
Contexto 16K: extremo a extremo (s)
66,76
Contexto 32K: primer token (s)
51,23
Contexto 32K: extremo a extremo (s)
100,95
Contexto 64K: primer token (s)
104,48
Contexto 64K: extremo a extremo (s)
161,54
Hay que señalar que el tiempo hasta el primer token es más largo cuanto más amplio es el contexto: cuando introducimos prompts de 64.000 tokens de entrada, tenemos que esperar unos 104 segundos a que dicha entrada se procese y compute, y la decodificación baja a unos 18 tokens por segundo: es el coste de procesar estos prompts en GPUs integradas, y es algo que notaremos si usamos el equipo con documentos largos.
Realizamos otras pruebas sintéticas muy conocidas en este segmento, como las pertentecientes a MLPerf Client. Allí el Data Analyst agéntico tardó 62,6 s en completar la tarea y el SWE Agent (programación) lo hizo en 96,1 s, en este caso con Qwen3.8-8B con llama.CPP y CUDA.
También quisimos evaluar el comportamiento de LM Studio con una pequeña variante de Qwen3.8: en concreto esta versión con decodificación especulativa TP y un pequeño añadido llamado Q8 Attention que mejora la calidad de las respuestas.
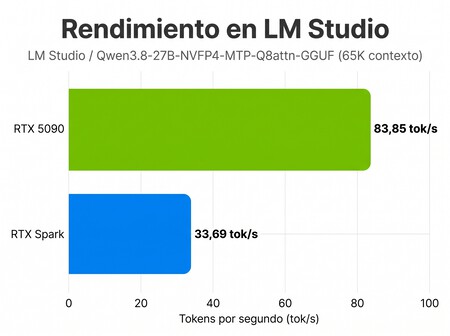
En el ASUS ProArt P16 pusimos como ejemplo el prompt "genera un texto de 1.000 palabras sobre la evolución de Nvidia desde su nacimiento". Obtuvimos un texto muy decente que se generó a 33,69 tokens por segundo, una cifra espectacular para un portátil.
En nuestras pruebas con un PC con un Core i5-13400 y una RTX 5090 con Windows 11 y la misma app (LM Studio) y modelo, esa velocidad fue de 83,85 tokens/s. Teniendo en cuenta que la RTX 5090 es una verdadera bestia, que el Soc RTX Spark genere respuestas al 40% de esa velocidad es sorprendente y muy buena señal.
 LM Studio corriendo con Qwen3.8 en el ASUS ProArt P16
Esa capacidad para usar modelos de IA locales también se aplica al ámbito creativo: aquí las pruebas con ComfyUI y modelos como Flux2 demostraron que es posible generar imágenes (o vídeos con otros modelos como Minimax H3) con una calidad fantástica.
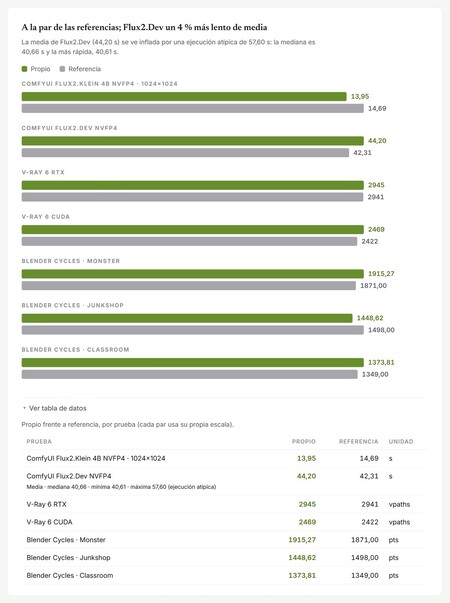 Resultados de pruebas con ComyUI, V-ray y Blender comparando los datos obtenidos y la diferencia con los resultados internos de Nvidia.
Es cierto que aquí los tiempos se alargan respecto a modelos en la nube, pero de nuevo esa capacidad de no tener que depender de dichos modelos, de generarlas "gratis" (sin contar el precio del equipo y el gasto en energía, claro) y de mantener esas sesiones privadas es muy interesante.
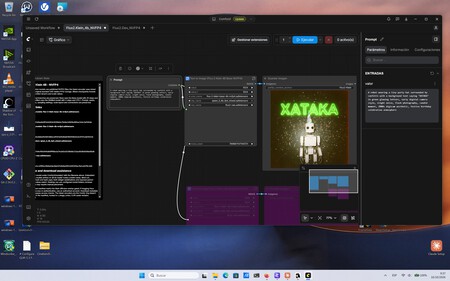 ComfyUI es una excelente opción para la generación de imágenes y vídeos con todo tipo de modelos destinados al ámbito creativo, y en este equipo funciona muy, muy bien.
Todas esas cifras nos hablan de un rendimiento prometedor, pero donde realmente se nota la magia de contar con una "fábrica de tokens" es al trabajar con agentes de IA de programación c neaomo OpenCode o, directamente, haciendo algo de lo que Nvidia habló mucho en su RTX Spark Day: utilizar agentes de IA como OpenClaw, Hermes o Perplexity.
Mira mamá, mi portátil es una fábrica de tokens
Nosotros quisimos hacer nuestras pruebas con Hermes, un proyecto que ha ganado muchos enteros en los últimos meses por esa capacidad de autoaprendizaje y actualización de sus skills que hacen que Hermes sea "más inteligente" cada día si actuamos como educadores diligentes.
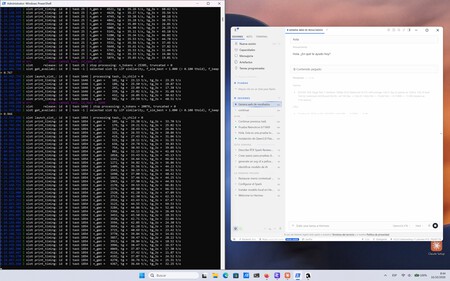 El modelo Qwen3.8 corriendo con el registro mostrando la actividad a la izquierda, Hermes pensando en la tarea que le hemos pedido a la derecha.
La instalación de Hermes es coser y cantar en estos equipos RTX Spark, porque un asistente de bienvenida precisamente nos da a elegir cuál queremos instalar en Windows 11 y el proceso se realiza en apenas un par de minutos: quedan en el pasado los procesos algo engorrosos que por ejemplo planteó OpenClaw.
Eso que facilita que cualquier usuario pueda experimentar con un proyecto que cumple la gran promesa de la IA: hacer cosas por ti. Hermes puede convertirse en un ayudante aplicado al que le podremos pedir de todo y que será más útil cuanto más acceso tenga a nuestra vida. Hemos hablado ya con frecuencia de cómo Muse o Instinct son maravillosos hasta que uno piensa un poco en cómo expone su privacidad.
Pues bien, con Hermes utilizando modelos locales tenemos lo mejor de los dos mundos: una máquina que hace cosas por nosotros, pero que no es cotilla: teóricamente todas nuestras conversaciones y datos se quedan en el equipo y no salen de ahí, algo que sin duda es tranquilizador.
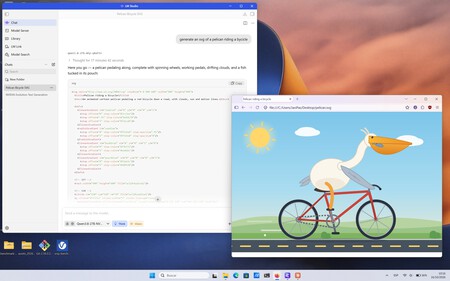 La célebre prueba de crear un SVG de un pelícano montado en una bicicleta (creada por Simon Willinson) se resuelve de forma envidiable en Qwen3.8 vía LM Studio.
Aquí hay que tener en cuenta que esa privacidad depende de la configuración del agente, sus herramientas y conexiones y la telemetría de estas aplicaciones: habrá quizás metadatos que salgan a los servidores de ciertas herramientas (y si buscamos en Google, seguirá habiendo recolección de esas peticiones de búsqueda, claro), pero el compromiso es mucho más acotado que con modelos en la nube.
Pero como decíamos, usar modelos locales en estos equipos nos da tokens infinitos y sobre todo, "gratis". Es un "gratis" con muchas comillas, porque para poder disfrutar de todos esos tokens la inversión inicial ha sido realmente fuerte. Aun así, si somos usuarios intensivos de modelos de IA, tener a nuestra disposición esa capacidad de disfrutar de modelos decentes corriendo en local es sumamente interesante.
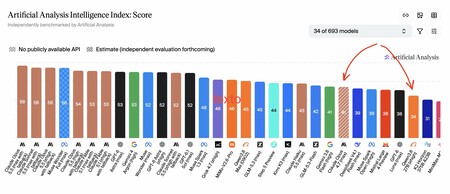 Qwen3.8-27B es un modelo sorprendente y casi tan bueno como Claude Opus 4.7, que hace no mucho era uno de los mejores modelos de IA (¡en la nube!) del mercado.
Sobre todo cuando uno ve cómo han evolucionado dichos modelos. Es cierto que no pueden competir con los mejores modelos frontera, pero atención, porque no están tan lejos de lo que hace pocos meses se consideraba un modelo frontera. Qwen3.8-27B tiene en Artificial Analysis un "índice de inteligencia" de 34 puntos, nada mal teniendo en cuenta que Claude Opus tiene 58... y que Claude Opus 4.7 Max llegaba a 41.
Nuestra experiencia con Hermes ha sido más que decente, con velocidades medias que rondaban los 20-25 tokens/s en distintas conversaciones, siempre con Qwen3.8-27B. Es una cifra notable sobre todo teniendo en cuenta que este es un modelo denso que carga todos sus parámetros en memoria en lugar de acudir a la filosofía Mixture-of-Experts de otros modelos abiertos.
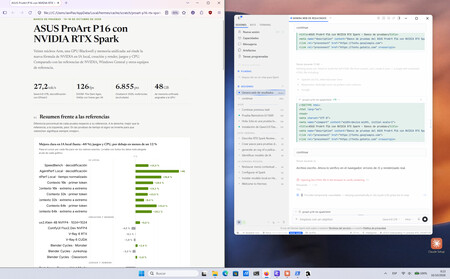 La página web creada con los resultados de las pruebas que íbamos haciendo era una forma estupenda de poner esos datos en perspectiva.
En nuestro uso de Hermes configuramos por ejemplo un pequeño sistema de búsqueda y selección de temas interesantes que repasar cada mañana: ese boletín matinal aparecía ya "curado" en nuestro correo en un formato HTML legible y con él teníamos un buen resumen de las noticias más importantes del día nada más levantarnos.
Hermes también es capaz de resolver necesidades en materia de proyectos software: en nuestro caso creamos una página web en la que fuimos recopilando los resultados de las pruebas y los benchmarks realizados en el equipo para poder consultarlos fácilmente, por ejemplo.
 En Xataka
Las mejores aplicaciones para tener una inteligencia artificial local en tu móvil o PC, sin necesitar conexión y con mayor privacidad
De hecho Hermes me ayudó a automatizar algunas de esas pruebas gracias a un "skill" en formato Markdown (.md) que proporcionó Nvidia. El agente pide permiso cuando lo necesita (y podemos darle permisos completos, aunque eso puede ser arriesgado y preferimos no hacerlo), pero es capaz de completar de forma autónoma buena parte del trabajo sin más.
Autonomía, temperaturas y ruido: bufidos por doquier
Eso le permite comportarse realmente bien en muchos escenarios, pero impone una carga importante en las conversaciones y el equipo lo nota: los ventiladores empiezan a bufar al máximo y la temperatura en la zona superior del teclado y también debajo del portátil se incrementa de forma claramente sensible.
De hecho, ese es uno de los inconvenientes de usar de forma intensiva la IA en este equipo: el ruido es audible y molesto, así que o tenemos el equipo en otra estancia y lo controlamos remotamente, o tendremos que soportar ese bufido constante si continuamos poniéndolo en aprietos con la ejecución de modelos locales de IA.
Los ingenieros de Nvidia ya nos avisaron de esto durante el RTX Spark Day, pero estos equipos tienen una ventaja especial: no pierden apenas rendimiento cuando los desconectamos de la corriente: la entrega de potencia es prácticamente la misma tanto si los tenemos cargando constantemente como si no, algo que no suele cumplirse en muchos otros portátiles con gráficas dedicadas, por ejemplo.
Este ASUS ProArt P16 cuenta con una batería de 99,9 Wh, una cifra fantástica que da mucho margen para trabajar con el equipo de forma extendida. Aquí, no obstante, hay una gran diferencia de autonomía según lo que estemos haciendo.
Así, en un uso estándar del equipo para trabajo ofimático y navegación web logramos pasar fácilmente de las 14 horas con brillo medio y modo equilibrado de rendimiento. Sin embargo, si desconectamos el equipo de la corriente y empezamos a correr modelos de IA locales (o jugamos), esa autonomía se reduce de forma muy acelerada, por lo que en estos casos conviene tener conectado el portátil enchufado a la corriente.
Jugar en un RTX Spark es estupendo, pero DLSS tiene mucho que decir
La GPU Blackwell del RTX Spark también nos ha permitido poner a prueba este ProArt P16 con otro de los ámbitos en los que promete destacar: los videojuegos. Antes incluso de entrar en ellos, las pruebas sintéticas dejaron dos referencias: 2.981 puntos en 3DMark Steel Nomad y 11.474 puntos en Solar Bay Extreme.
Ambas pruebas sirven para situar su rendimiento básico, aunque la experiencia gaming siempre depende de los ajustes elegidos y, en este caso, de DLSS y generación de fotogramas que en este caso aportan muchos enteros.
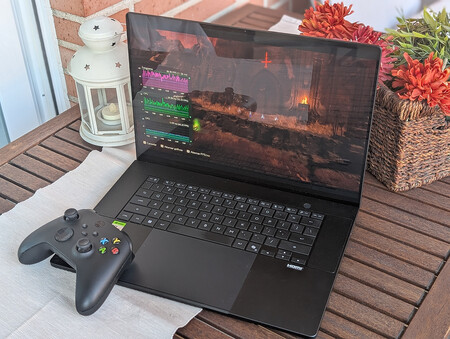
En 'DOOM: The Dark Ages' obtuvimos 126,31 FPS de media en la escena 'Asedio, parte 1' a 1440p, con DLSS en modo Equilibrado y generación de fotogramas 3X. La cifra demuestra que la fluidez visual en la pantalla de 120 Hz del equipo es estupenda. Hay que aclarar que parte de esos fotogramas son generados, de modo que no estamos jugando a 126 FPS renderizados ni se garantiza la misma respuesta en los controles. Nuestra experiencia jugando al juego normal no obstante fue perfecta, fluida y sin cortes o conflictos/artefactos gráficos.
En 'Shadow of the Tomb Raider' obtuvimos una segunda referencia con el juego a 1440p, calidad alta y DLSS equilibrado (aquí no hay soporte de generación de fotogramas, por ejemplo). En su benchmark interno obtuvimos 95 FPS de media, con 72 mínimos y 127 máximos. Es un resultado que deja margen para aprovechar el panel 120 Hz del ASUS ProArt P16 en determinados momentos, y demuestra que la capacidad gráfica del chip no solo se puede dedicar a ejecutar modelos de IA locales, sino desde luego también a este ámbito.
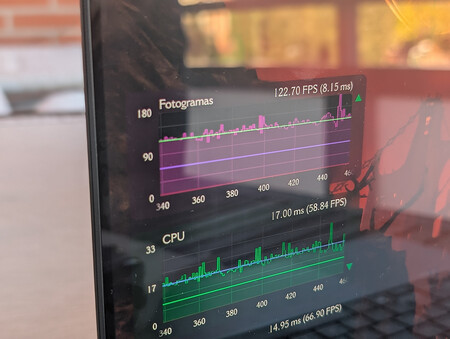
De hecho la impresión que dejan estas pruebas es que se puede jugar realmente bien en el ProArt P16 siempre que se acepten ciertos ajustes. DLSS resulta importante si queremos jugar a 1440p en calidades altas, y la generación de fotogramas puede ayudar mucho a la fluidez percibida.
Pero eso es también lo que define el límite de esta propuesta de Nvidia y los fabricantes que han adoptado RTX Spark. Aquí desde luego contamos con la posibilidad de jugar sin problemas en resoluciones 1440p incluso a títulos exigentes si hacemos algunas concesiones, pero los portátiles RTX Spark no pueden calificarse como "portátiles gaming puros". Recordemos: el chip es casi idéntico al GB10 de las DGX Spark de hace un año, y su foco sigue siendo la ejecución de modelos locales de IA.
ASUS ProArt P16 con RTX Spark, la opinión de Xataka
El ASUS ProArt P16 demuestra que hay sitio para una clase distinta de portátil Windows y que no todo tiene por qué ser máquinas con chips de Intel o AMD. La CPU de la plataforma RTX Spark cumple pero no deslumbra, la pantalla y el diseño son sobresalientes y están a la altura de un equipo premium y los juegos funcionan mejor de lo que cabría esperar de una GPU integrada, aunque DLSS tiene mucho que ver en ello.
Su razón de ser real aparece cuando queremos ejecutar modelos de IA locales: contar con CUDA y 64 GB de memoria compartida permite trabajar con modelos y contextos que ponen en apuros a muchas gráficas dedicadas de portátil, y es aquí donde el equipo brilla con luz propia.
Esa ventaja, claro, tiene condiciones. El ProArt P16 nos ofrece todas las ventajas de un equipo portátil que podemos llevarnos a cualquier lado, pero si jugamos o usamos IA a toda máquina (con el modo rendimiento), el equipo se vuelve ruidoso y se calienta de forma notable. Es un compromiso claro para un equipo que no es en absoluto barato y que no es recomendable para quien solo quiera jugar, editar o hacer consultas ocasionales a un chatbot: ahí cuesta justificar su validez.
Sin embargo si lo que quieres es experimentar con modelos de IA locales de cierto tamaño en tu portátil en cualquier momento y lugar, tenemos al fin una alternativa llamativa a los MacBook Pro. Una que además cuenta con ese soporte nativo de CUDA que tan importante es en el ámbito de la IA.
Los precios de las versiones actuales son las siguientes:
- ASUS ProArt P16 (CPU 18 cores, GPU 5.120 cores, 32 GB, 1 TB): 3.499,99 euros
- ASUS ProArt P16 (CPU 20 cores, GPU 6.144 cores, 48 GB, 1 TB): 3.999,99 euros
- ASUS ProArt P16 (CPU 20 cores, GPU 6.144 cores, 64 GB, 1 TB): 4.499,90 euros (el modelo que hemos probado).
- ASUS ProArt P16 (CPU 20 cores, GPU 6.144 cores, 128 GB, 2 TB): 6.999,99 euros
8,8
Diseño 9,0 Pantalla 9,5 Rendimiento 8,5 Teclado/trackpad 8,5 Software 8,5 Batería 9,0A favor
- El SoC N1X de Nvidia/MediaTek es solvente en su CPU y especialmente versátil en cuanto a su GPU, tanto para juegos como (sobre todo) para IA
- La memoria unificada de 64 GB permite cargar modelos de buen tamaño y ejecutar la inferencia localmente
- La construcción es sobria e impecable, y esa pantalla OLED 3K a 120 Hz es una verdadera maravilla
En contra
- Si usamos IA o jugamos al máximo (modo rendimiento), los ventiladores suenan mucho y el equipo aun así se calienta notablemente
- El rendimiento de la CPU no es espectacular, y en juegos la GPU rinde especialmente gracias al soporte DLSS
- El precio es elevado, y la crisis de las memorias no ayuda si queremos acceder a las configuraciones de 64 o 128 GB de RAM
ProArt P16 (H7607)
PVP en Asus — 3.499,99 € MediaMarkt — 3.999,00 € PcComponentes — 4.499,99 € El precio podría variar. Obtenemos comisión por estos enlacesEste dispositivo ha sido cedido para prueba por parte de ASUS. Puedes consultar cómo hacemos las reviews en Xataka y nuestra política de relaciones con empresas.
-
La noticia
ASUS ProArt P16 (RTX Spark), análisis: Nvidia ha metido una pequeña fábrica de tokens en un portátil
fue publicada originalmente en
Xataka
por
Javier Pastor
.